K-D Tree
引入
K-D Tree 是用来处理 \(k\) 维信息的一种数据结构,这里 \(k\) 一般为 \(2/3\) 。
他的优势在于空间小,可以强制在线,但是由于时间复杂度的保证源于各种剪枝,优化。因此时间复杂度面对非随机数据不稳定。
建树
但是具体这颗 K-D Tree 是如何完成的? 首先对于 \(k\) 维树的每一层选择一维,然后每一层选择一个节点,把整个空间分成两半,然后递归处理。具体来说比如对于下图 \(k=2\) 的情况:
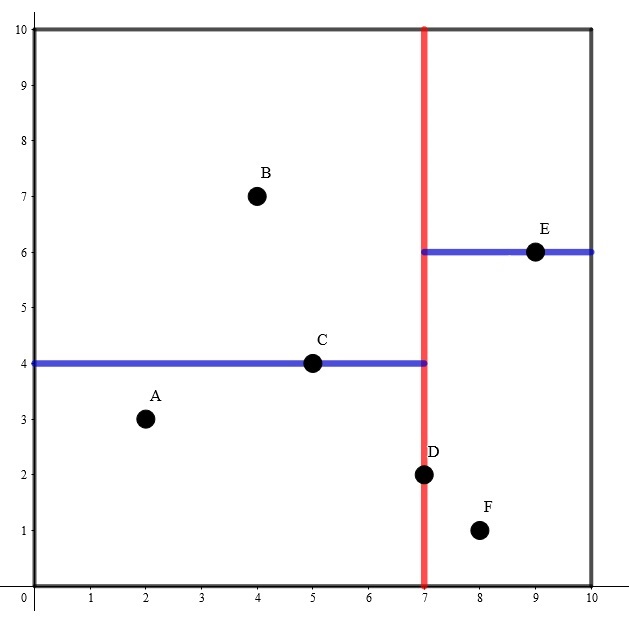
此时第一次选择了 \(D\) ,然后递归到两边一边选择 \(C\) ,一边选择 \(E\) ,然后每一个切割出来的矩形为一个子树,每一个节点的儿子为其递归下去的两个子树的根,如下:
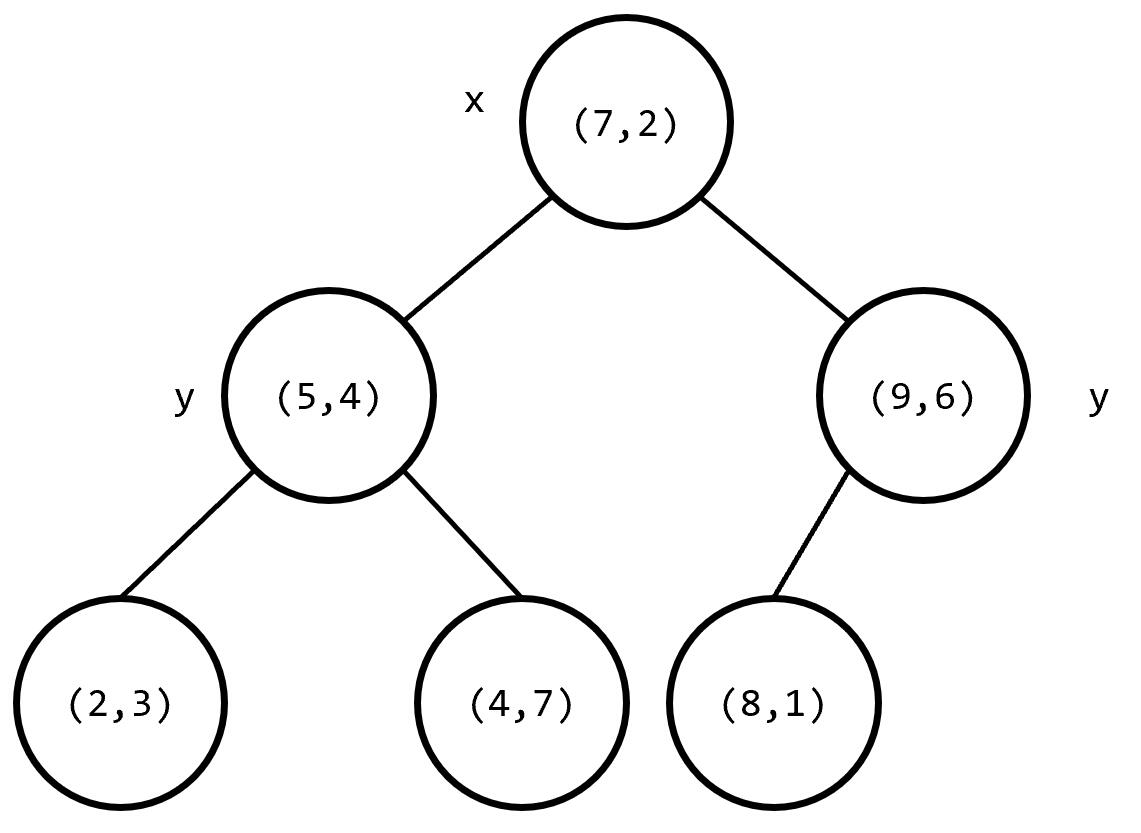
当然为了使这颗树尽可能优秀,我们需要满足以下要求:
-
每一层的维度依次遍历
-
每一个子区间选择的节点需要按照那一位排序之后的中位数。
可以发现此时树高不超过 \(\log n\) 。
但是如何快速求解中位数呢,可以使用库提供的 nth_element 函数,其作用是在你自定义的比较函数下把排名为 \(k\) 的数放在他的位置上,然后左边都比他小,右边都比他大,实际上就是快排的中间一步。具体实现:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | |
可以发现时间复杂度大致为 \(\mathcal O(N \log N)\) 。
查询
基础模板题的查询就是查询区间信息,这种情况下,我们采用 暴力+剪枝 的办法处理。具体来说:
-
如果当前节点代表区间都在查询范围,那么直接返回预先迭代好的区间信息。
-
如果当前节点代表区间和查询范围没有交集,那么直接返回 \(0\) 。
-
否则先计算当前节点是否在查询区间内,在就加入贡献,然后递归两个子树。
这种做法在随机数据下时间复杂度为 $ \mathcal O(N^{1-\frac{1}{k}})$ 。
参考代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | |
但是其实大部分是否 K-D Tree 查询的都是与某一个点满足什么关系的其他点,其实这里只要满足一个区间只要四个角都满足,那么整个区间都满足(即所有能够满足的点为一个凸图形),此时就可以按照相同的道理剪枝。
插入
如果需要新插入一个节点又该怎么办呢?因为这个 K-D Tree 是一个二叉树,所以很自然的可以想到想堆一样维护。但是很明显过于麻烦了。
我们可以采用二进制分组的方式维护。即维护多个 K-D Tree ,每一个的大小都必须刚好是 \(2\) 的整次幂,然后每当新加入一个点,我们先为他建一个一个点的数。然后查看有没有大小为 \(1\) 的数,有没有大小为 \(2\) 的数,··· ,看一下最多有从 \(1~k\) 都有树的。然后把他们的节点全部记录下来,重新建树建到 \(root(k+1)\) ,玄学时间复杂度,均摊 \(\mathcal O(\log N)\) 。
示例代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | |
修改
一般的操作是把给定区间内的所有点都进行一个统一的修改,其实和查询是一个道理,只不过加一个懒标记。直接上代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | |
最后
[!success]- 完整代码 for P14312 【模板】K-D Tree
struct KD_Tree {
    static constexpr int N = 5e5+5, K = 3, LG=20;

    #define lc (T[p].ls)
    #define rc (T[p].rs)

    int cnt;
    struct Node {
        int ls, rs;
        int d[K];
        int tag, siz;
        int sum, val;
        int Min[K], Max[K];
        // d[K]: 点的坐标
        // sum: 区间权值和 , val: 节点权值
        // Min[k]: 区间某维度最小坐标 , Max[k]: 略
    }T[N];

    int new_node(int d[K], int A) {
        T[++cnt] = Node { 0, 0, {1, 1, 1}, 0, 1, A, A};
        // for(int k=0;k<K;k++) T[cnt].d[k] = d[k];
        memcpy(T[cnt].d, d, sizeof T[cnt].d);
        return cnt;
    }

    int m, root[20]; // 二进制优化后的每一颗子树 rt

    void push_up(int p) {
        T[p].siz=T[lc].siz+T[rc].siz+1;
        T[p].sum=T[lc].sum+T[rc].sum+T[p].val;
        for(int k=0; k<gk; k++) {
            T[p].Min[k] = T[p].Max[k] = T[p].d[k];
            if(lc) {
                T[p].Min[k]=min(T[p].Min[k], T[lc].Min[k]);
                T[p].Max[k]=max(T[p].Max[k], T[lc].Max[k]);
            }
            if(rc) {
                T[p].Min[k]=min(T[p].Min[k], T[rc].Min[k]);
                T[p].Max[k]=max(T[p].Max[k], T[rc].Max[k]);
            }
        }
    }

    void push_down(int p) {
        if(!T[p].tag) return;
        if(lc) {
            T[lc].sum += T[p].tag*T[lc].siz;
            T[lc].val += T[p].tag;
            T[lc].tag += T[p].tag;
        }
        if(rc) {
            T[rc].sum += T[p].tag*T[rc].siz;
            T[rc].val += T[p].tag;
            T[rc].tag += T[p].tag;
        }
        T[p].tag=0;
    }

    int build(int l, int r, int dep, vector<int>* b) { // 建树
        if(l>r) return 0;
        if(l==r) {
            push_up(b->at(l));
            return b->at(l);
        }

        int mid=(l+r)>>1;
        nth_element(b->begin()+l, b->begin()+mid, b->begin()+r+1, [&](int x, int y) {
            return T[x].d[dep] < T[y].d[dep];
        });

        int p=b->at(mid);
        lc=build(l, mid-1, (dep+1)%gk, b);
        rc=build(mid+1, r, (dep+1)%gk, b);
        push_up(p); return p;
    }

    void append(int& p, vector<int>* b) { // 删树
        if(!p) return ;
        b->push_back(p);
        push_down(p);
        append(lc, b), append(rc, b);
        p=0; // 删除节点
    }

    vector<int> b;
    void insert(int d[K], int A) {
        b.clear(); // 占位符
        m++, b.push_back(new_node(d, A));
        for(int siz=0; siz<LG; siz++) {
            if(!root[siz]) {
                root[siz] = build(0, b.size()-1, 0, &b);
                break;
            }else append(root[siz], &b);
        }
    }

    int query_rt(int p) {
        if(!p) return 0;
        push_down(p);
        {
            int flag=1;
            for(int k=0; k<gk; k++) flag &= (l[k]<=T[p].Min[k] && T[p].Max[k]<=r[k]);
            if(flag) return T[p].sum;
        } {
            for(int k=0; k<gk; k++) if(r[k]<T[p].Min[k] || T[p].Max[k]<l[k])
                return 0;
        } {
            int ans=0, flag=1;
            for(int k=0; k<gk; k++) flag &= (l[k]<=T[p].d[k] && T[p].d[k]<=r[k]);
            if(flag) ans=T[p].val;
            return ans + query_rt(lc) + query_rt(rc);
        }
    }

    void update_rt(int p, int x) {
        if(!p) return ;
        push_down(p);
        {
            int flag=1;
            for(int k=0; k<gk; k++) flag &= (l[k]<=T[p].Min[k] && T[p].Max[k]<=r[k]);
            if(flag) { // 完全包含
                T[p].sum += x*T[p].siz;
                T[p].val += x;
                T[p].tag += x;
                return ;
            }
        } {
            for(int k=0; k<gk; k++) if(r[k]<T[p].Min[k] || T[p].Max[k]<l[k])
                return ; // 完全没有相交
        } {
            int flag=1;
            for(int k=0; k<gk; k++) flag &= (l[k]<=T[p].d[k] && T[p].d[k]<=r[k]);
            if(flag) T[p].val+=x;;
            update_rt(lc, x) , update_rt(rc, x);
            push_up(p);
        }
    }

    int query() {
        int ans=0;
        for(int i=0; i<LG; i++)
            ans+=query_rt(root[i]);
        return ans;
    }

    void update(int v) {
        for(int i=0; i<LG; i++)
            update_rt(root[i], v);
    }
}T;